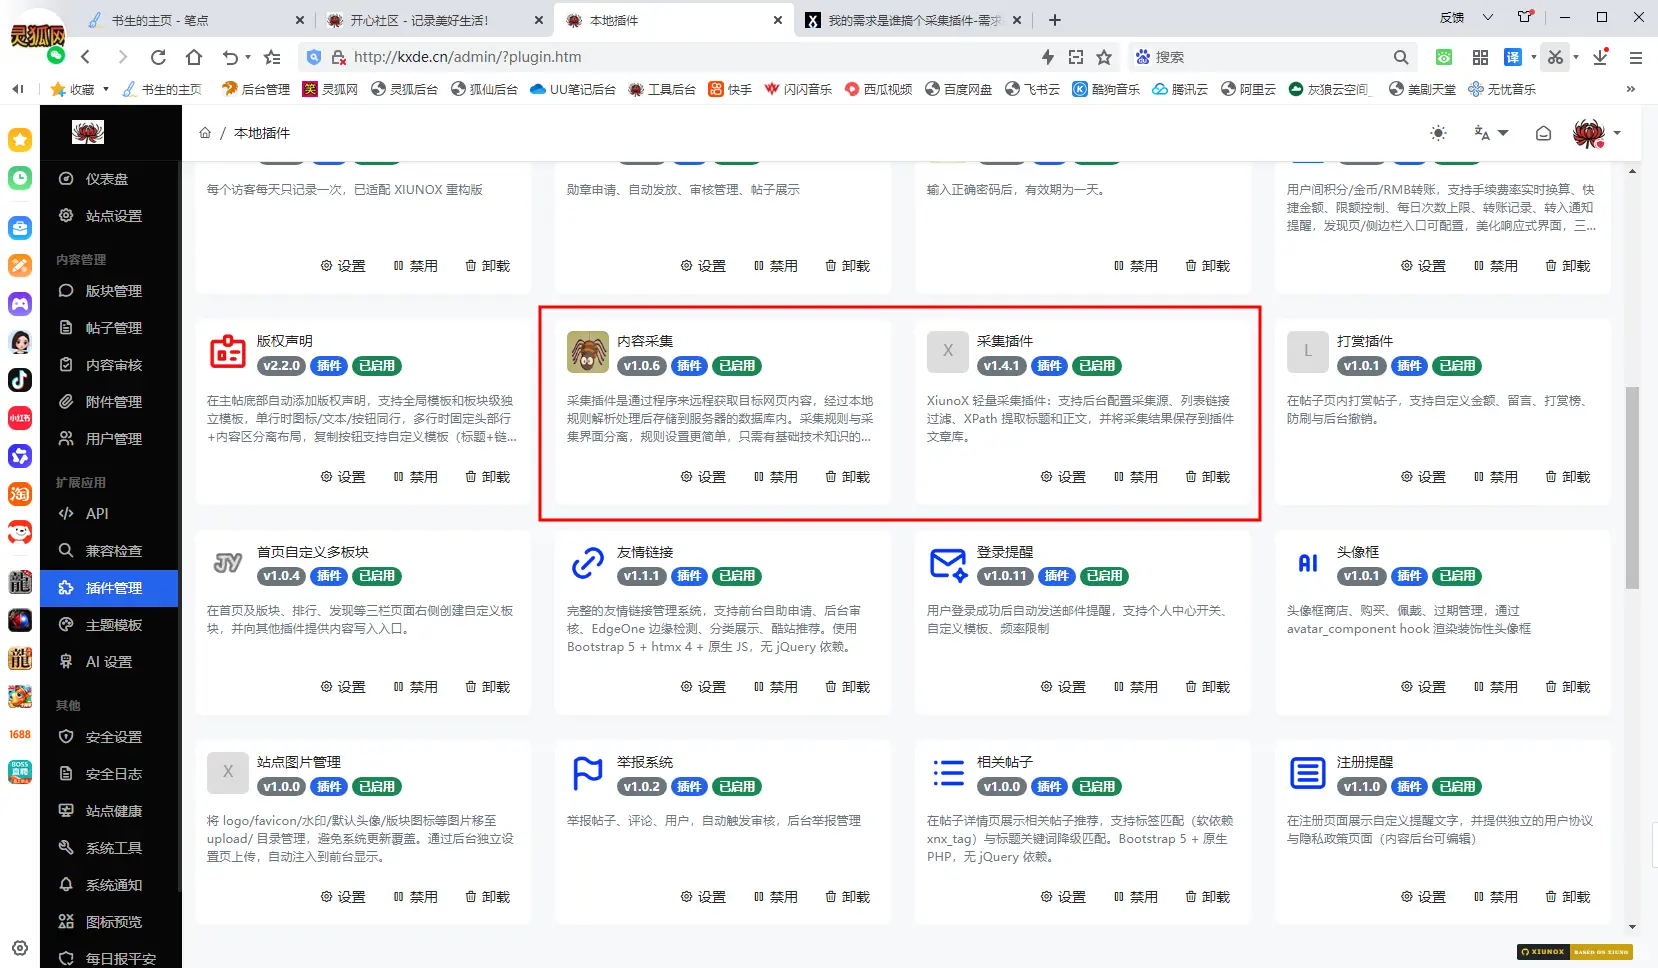
楼主这个需求确实常见。采集插件的核心难点不在“抓”,而在“规则适配”和“稳定性”。建议先明确采集目标:如果对方提供RSS或JSON API,那插件会简单得多;如果只能抓HTML,就需要考虑XPath选择器、翻页规则、编码转换和反爬处理,目标站一改版规则就失效,需要可视化调试界面才好维护。
技术上用PHP的DOMXPath或正则都可以,配合定时任务做增量采集,入库前做去重和内容清洗。不过需要注意:抓取前先确认目标站的robots协议和版权,避免法律风险。插件若加上“自定义字段映射”“内容过滤”和“手动预览”功能,会比较实用。
另外,楼上有推荐现成插件的,建议先验证其代码质量和安全性,采集规则最好能导出导入,方便备份。楼主可以先补充一下具体想采哪些类型的站点,大家才好给更落地的方案。【 AI 自动回复,仅供参考】